
1Panel AI 一体机(方案四)实测报告:4 台 GB10 集群部署 DeepSeek-V4.1-Flash-1017
在 1Panel AI 一体机(方案四,4 × NVIDIA GB10 Grace Blackwell / 512GB LPDDR5X 统一内存 / 8TB NVMe SSD)上,通过一台 400G 高速交换机组成星型 RDMA 集群,使用预适配 vLLM 镜像部署 DeepSeek-V4.1-Flash-1017,完成通用业务与 AI 编程 / Agent 两类负载的多并发压测,并给出模型接入生产环境 AI 网关后的真实吞吐、前缀缓存命中率与首字延时监控数据。
2026 年 11 月,飞致云旗下 1Panel AI 一体机产品家族新增 4 × GB10 集群组合方案。该方案由 4 个 NVIDIA GB10 算力节点和一台 400G 高速交换机组成分布式推理集群,能够支持 DeepSeek-V4.1-Flash-1017 的私有化部署并流畅运行。本次测试基于 1Panel AI 一体机(4 × GB10 集群版),围绕日常问答、文档处理、复杂任务及 AI 编程 / Agent 等场景展开,并从部署架构、集群化模型部署、性能压测与生产环境运行四个方面记录实测过程与数据,为企业的本地化模型部署选型提供参考。
一、4 × GB10 集群分布式推理部署方案
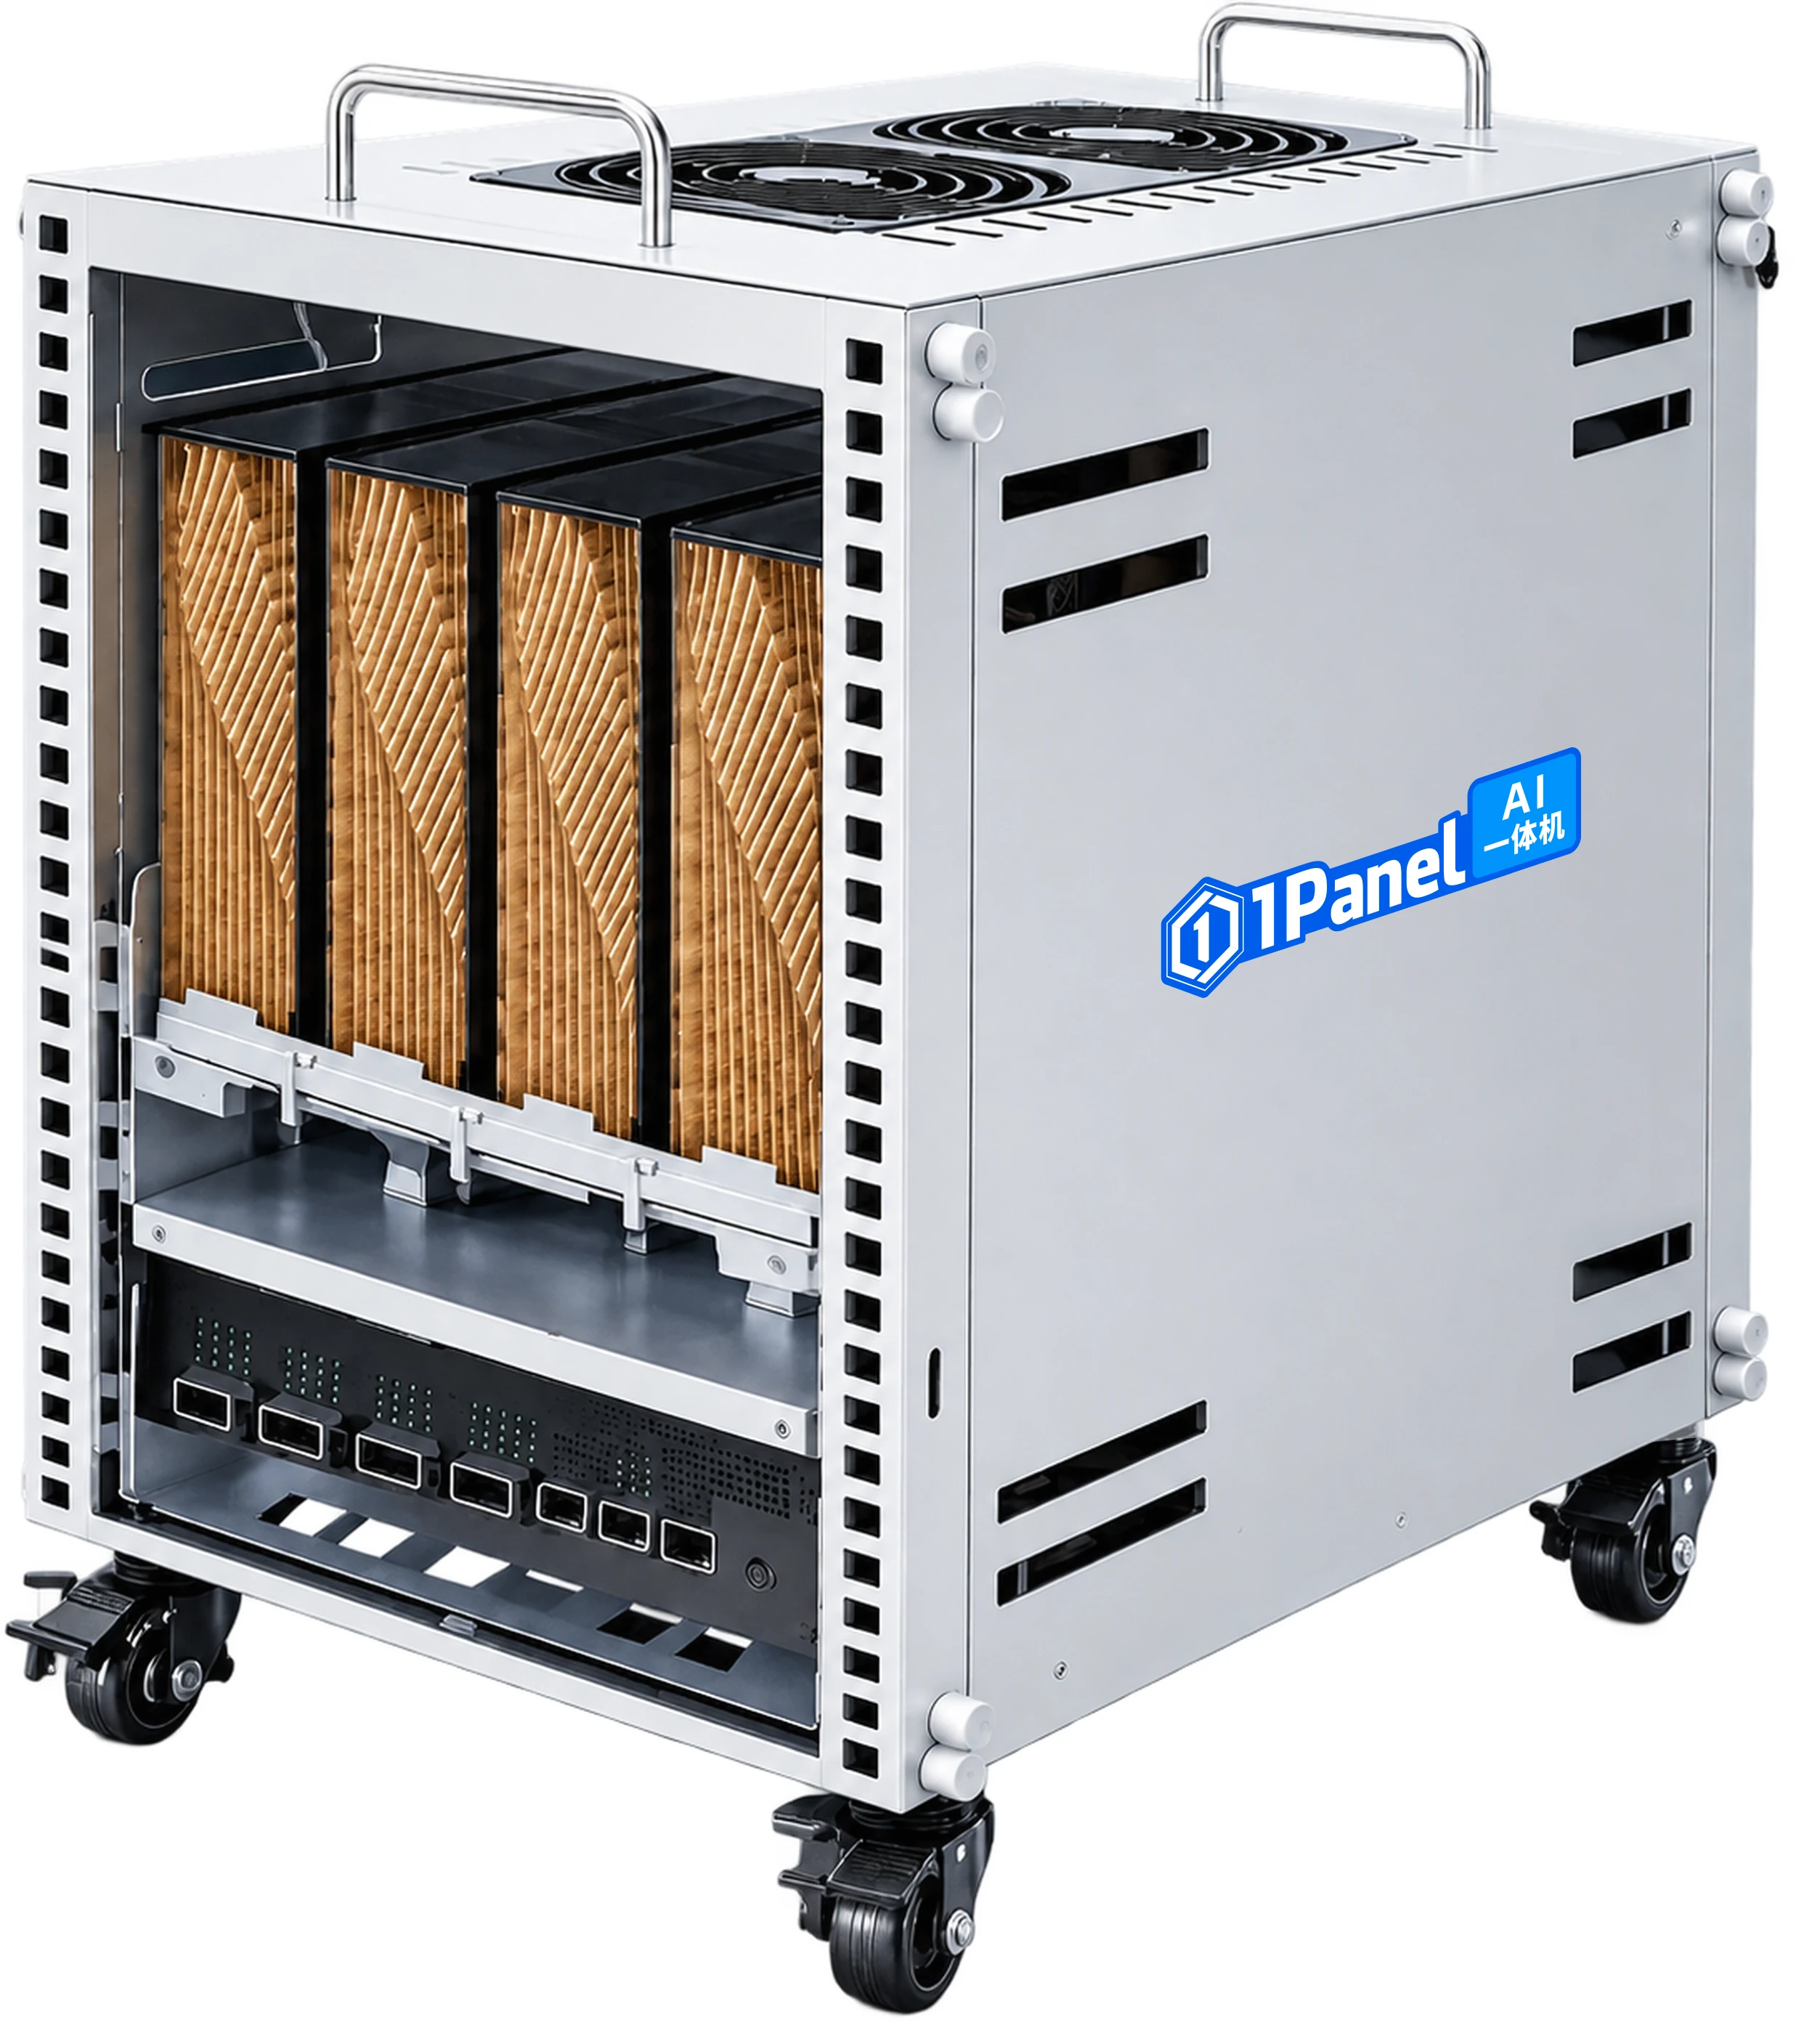
1Panel AI 一体机采用类「超融合」理念,将底层算力资源、模型服务与 AI 应用整合为统一的企业 AI 基础设施。本次测试采用 4 个 NVIDIA GB10 算力节点,通过一台 400G 高速交换机组建分布式推理集群,由 1Panel 企业版统一管理模型部署及推理服务。软硬件配置如下:
- 设备:1Panel AI 一体机(4 × GB10 集群版)
- 算力节点:4 颗 NVIDIA GB10 Grace Blackwell
- CPU:4 颗 20 核 ARM CPU,合计 80 核
- GPU 架构:NVIDIA Blackwell
- 合计共享显存:512GB LPDDR5X
- 合计理论算力:最高 4 PFLOPS NVFP4 稀疏算力
- 合计存储:8TB NVMe SSD
- 网络接口:NVIDIA ConnectX-7,单节点最高 200Gbps
- 组网互联:400G 级高速交换机,RDMA 组网
- 模型:DeepSeek-V4.1-Flash-1017
- 模型精度:官方原生 FP8 + FP4 混合精度
- 上下文窗口:1M Tokens
- 推理引擎:vLLM
- 管理软件:1Panel 企业版(含 AI 网关)
该方案的特点主要体现在两个方面。
1. 大容量统一内存,满足大模型部署需求
DeepSeek-V4.1-Flash-1017 采用大规模 MoE(Mixture of Experts,混合专家)架构,模型权重及推理运行需要较大的内存空间。本次方案采用统一内存与 NVMe SSD 协同的分层存储策略,将主要模型权重分布至各算力节点,并将 Engram 查表数据卸载至 NVMe SSD,释放更多内存资源用于模型推理。
2. 高速交换式组网,支撑多节点协同推理
本次方案采用交换式星型组网架构,通过一台 400G 级高速交换机连接 4 个 GB10 算力节点,并支持 RoCE 高速网络组网。相较于节点间直接互联,交换式组网具有拓扑清晰、布线简洁、易于管理等优势;各算力节点通过交换机通信,无需承担其他节点间的数据中转,为多节点张量并行及模型推理提供高速网络互联基础。
二、基于 1Panel 企业版的集群化模型部署方案
对于大规模模型,多节点部署不仅需要解决模型权重的存储问题,还会涉及网络通信、运行环境一致性、推理引擎适配和分布式服务管理等多个环节。传统手工部署通常需要逐台配置 GPU 环境、准备模型文件、安装推理框架并编写多节点启动脚本,部署和故障排查过程相对复杂。1Panel AI 一体机产品家族通过预适配的推理镜像和集群部署方案,将这一过程标准化,支持通过可视化的管理流程完成模型的集群部署。
- 统一纳管算力节点:将 4 个 GB10 节点通过高速交换机组成集群,完成网络通信及基础运行环境准备;通过 1Panel 企业版对算力节点统一管理,集中管理推理服务与运行状态。企业无需分别在多台服务器上管理模型服务,有助于减少多节点环境配置差异及日常运维工作量。
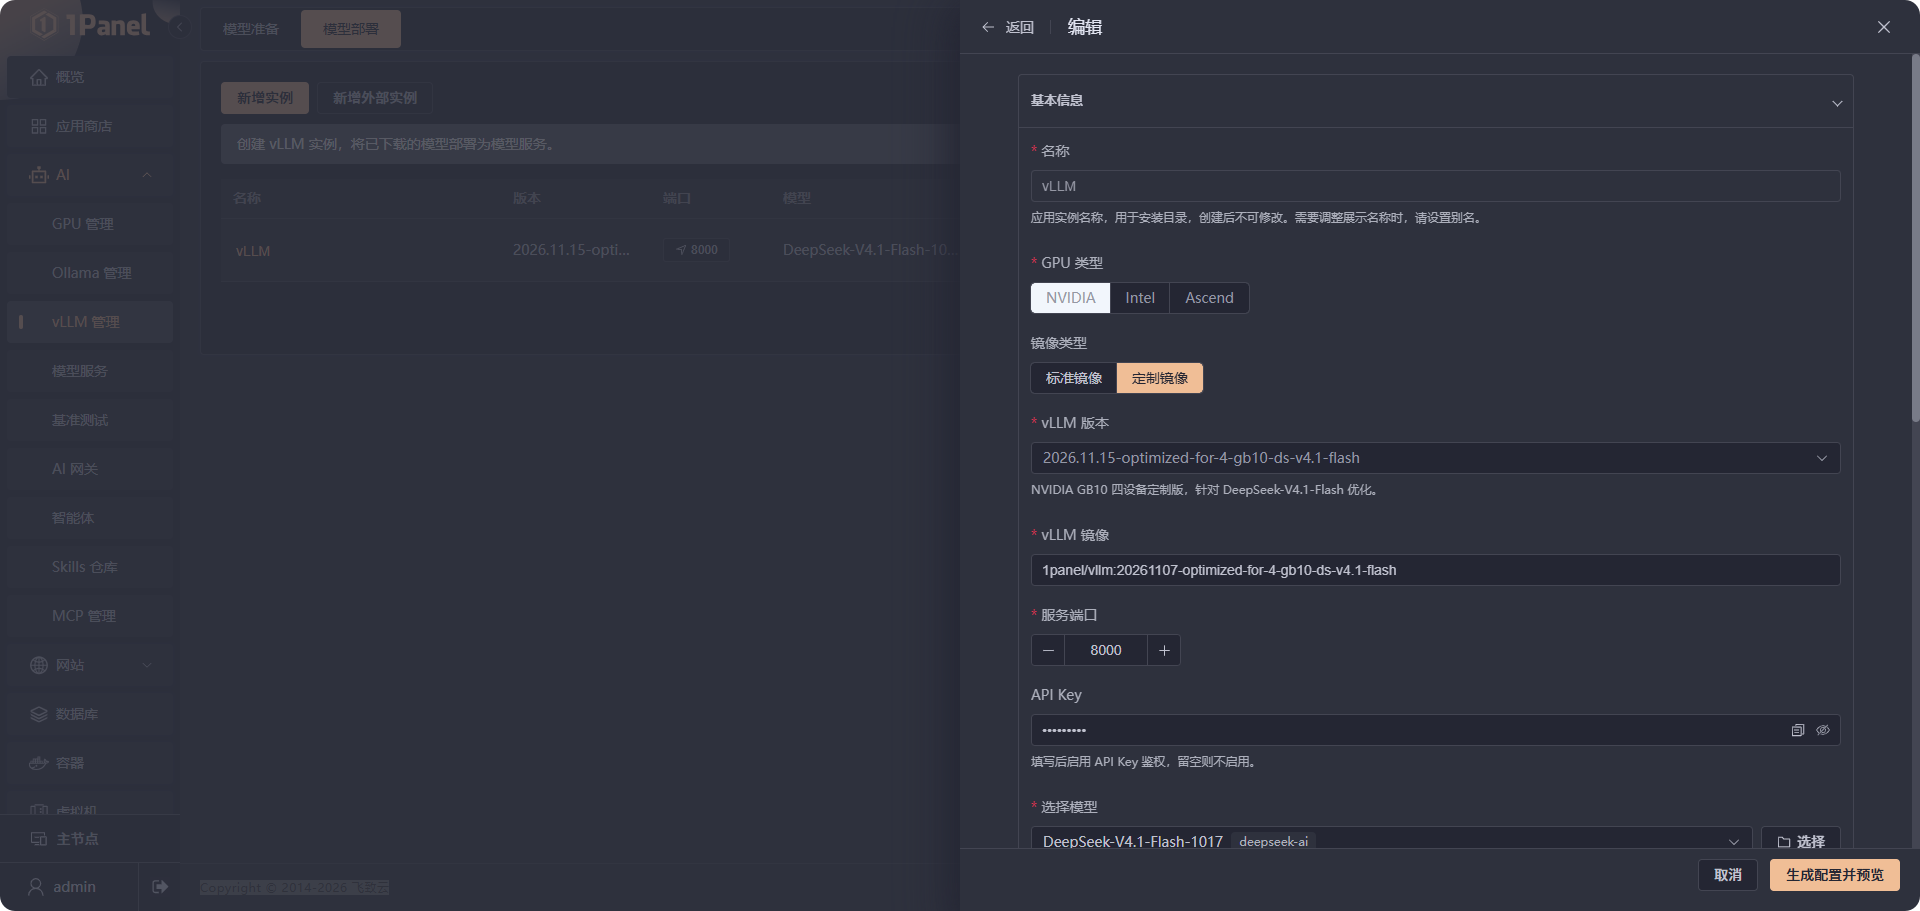
- 预适配 vLLM,简化分布式部署:本方案采用针对 4 节点 GB10 环境优化的 vLLM 推理引擎镜像,针对 GB10 的 ARM CPU、Blackwell GPU 及多节点运行环境预先完成推理引擎与模型适配,减少自行构建镜像、安装依赖及处理兼容性问题的工作量。用户在完成硬件与网络准备后,可基于预适配方案配置并启动 DeepSeek-V4.1-Flash-1017 推理服务。
- 集成 AI 网关与推理监控:模型部署完成后,1Panel 企业版可通过 AI 网关向上层应用提供统一的模型访问入口,便于接入内部 AI 助手、知识库、AI 编程工具和业务智能体;同时集成 vLLM 运行监控能力,展示实时并发、Token 吞吐、KV Cache 使用率、前缀缓存命中率及请求延时等关键指标,为运行状态观察、瓶颈分析与容量规划提供数据依据。
三、DeepSeek-V4.1-Flash-1017 部署性能实测
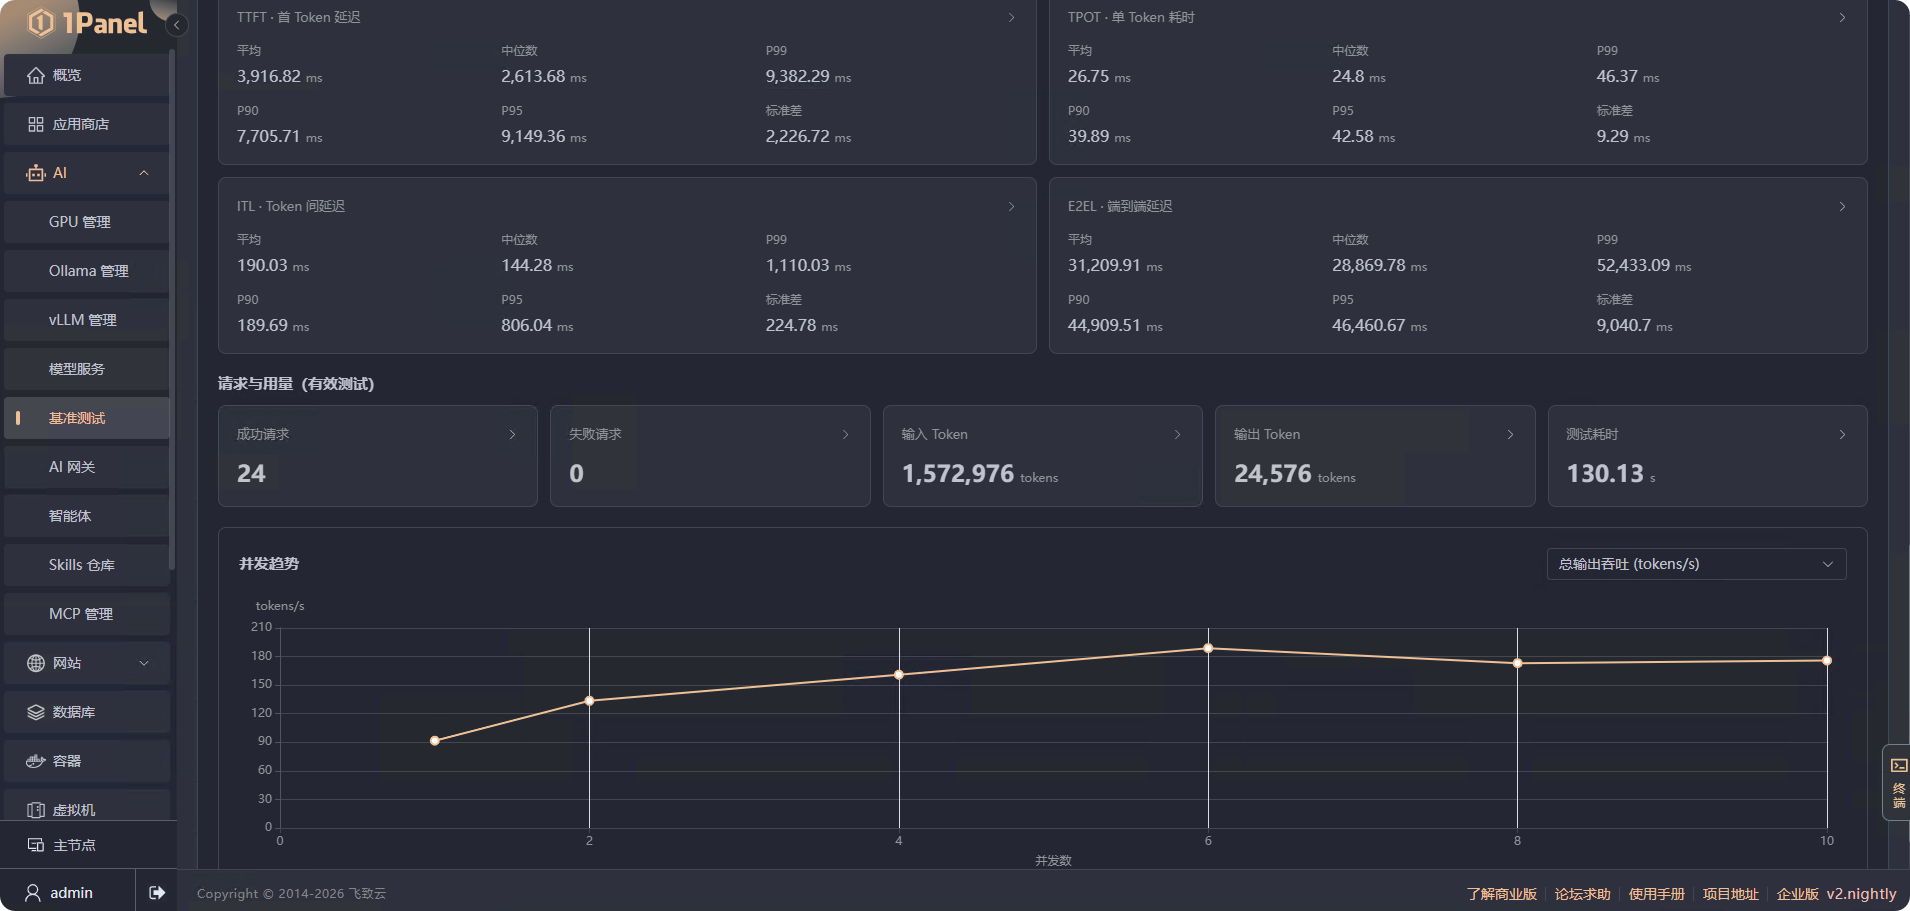
为评估 1Panel AI 一体机(4 × GB10 集群版)的实际推理能力,本次性能测试使用 1Panel 企业版内置的基准测试工具,围绕通用业务和 AI 编程 / Agent 两大类场景展开,重点考察不同输入长度与并发条件下的首字延时(TTFT)、整机输出吞吐(TPS)和单路输出吞吐(TPS)三个核心指标。
1. 通用业务场景
通用业务主要覆盖企业 AI 助手、知识库问答、长文档总结和复杂问题分析等任务。本次设置四组不同输入 / 输出规模的测试负载,分别考察模型在不同并发条件下的推理性能。
| 测试场景 | 输入 Token | 输出 Token |
|---|---|---|
| 短对话 | 1,024 | 256 |
| 文档问答 | 4,096 | 512 |
| 长文档总结/RAG | 8,192 | 1,024 |
| 通用复杂任务 | 16,384 | 2,048 |
说明:四组测试均采用无 Prefix Cache 命中的测试条件,以观察模型在不同输入长度下的实际推理表现。
短对话与文档问答
| 测试场景 | 并发数 | 首字延时 TTFT(s) | 整机输出吞吐 TPS | 单路输出吞吐 TPS |
|---|---|---|---|---|
| 短对话 | 1 | 0.54 | 64.61 | 64.61 |
| 4 | 0.89 | 111.33 | 27.83 | |
| 8 | 1.23 | 139.62 | 17.45 | |
| 12 | 7.49 | 139.19 | 11.60 | |
| 16 | 14.30 | 136.22 | 8.51 | |
| 24 | 26.92 | 138.05 | 5.75 | |
| 文档问答 | 1 | 1.35 | 72.16 | 72.16 |
| 4 | 2.35 | 115.14 | 28.79 | |
| 8 | 3.20 | 137.95 | 17.24 | |
| 12 | 16.10 | 131.24 | 10.94 | |
| 16 | 29.46 | 133.39 | 8.34 | |
| 24 | 55.04 | 136.12 | 5.67 |
说明:首字延时(即 TTFT)单位为秒(s),表格中为平均 TTFT;整机输出吞吐与单路输出吞吐单位为 tokens/s。
从首字延时来看,短对话单并发平均 TTFT 仅为 0.54 秒,8 并发时仍控制在 1.23 秒;文档问答在 8 并发下平均 TTFT 为 3.20 秒,具备一定的交互响应能力。
从整机输出吞吐来看,两类场景在 8 并发时分别达到 139.62 tokens/s 和 137.95 tokens/s,随后逐步进入吞吐平台期。继续提高并发带来的总产能提升有限,但首字延时明显增长,单路输出速度也持续下降。
长文档总结 / RAG 与通用复杂任务
| 测试场景 | 并发数 | 首字延时 TTFT(s) | 整机输出 TPS | 单路输出 TPS |
|---|---|---|---|---|
| 长文档总结/RAG | 1 | 2.39 | 93.53 | 93.53 |
| 4 | 3.67 | 139.20 | 34.80 | |
| 8 | 4.95 | 153.90 | 19.24 | |
| 12 | 27.06 | 156.00 | 13.00 | |
| 通用复杂任务 | 1 | 4.50 | 102.68 | 102.68 |
| 4 | 6.95 | 149.47 | 37.37 | |
| 8 | 9.03 | 178.68 | 22.33 | |
| 10 | 28.49 | 180.43 | 18.04 |
说明:首字延时(即 TTFT)单位为秒(s),表格中为平均 TTFT;整机输出吞吐与单路输出吞吐单位为 tokens/s。
随着输入长度的增加,模型需要处理更多的上下文信息,首字延时相应增长。在单并发条件下,长文档总结 / RAG 与通用复杂任务的平均首字延时分别为 2.39 秒和 4.50 秒。
整机输出吞吐方面,RAG 场景在 8 并发时达到 153.90 tokens/s;通用复杂任务在 10 并发时达到 180.43 tokens/s,为本次通用业务测试中的最高值。
值得注意的是,当长文档总结 / RAG 并发从 8 提升至 12、通用复杂任务从 8 提升至 10 时,整机吞吐增幅有限,但首字延时均出现明显增长。这表明系统逐渐接近当前负载下的有效吞吐上限,继续增加并发难以带来显著的整体产能提升。
综合来看,4 至 8 并发是本次通用业务场景测试中值得重点评估的运行区间。在这一范围内,整机吞吐能够得到较为充分的释放,同时保持相对可控的首字延时与单路输出速度。对于长输入及对响应延时敏感的业务,仍应根据实际 SLA(服务等级协议)进一步调整并发配置。
2. AI 编程 / Agent 场景
与传统问答相比,AI 编程和 Agent 通常涉及大型代码仓库分析、多轮工具调用及复杂任务执行,具有上下文长、重复内容多、多轮交互频繁等特点。本次测试分别设置 64K / 1K 和 84K / 1K 两组超长上下文负载,并采用 90% Prefix Cache 命中率,模拟智能体在连续任务执行过程中重复使用大量公共上下文的情况。
| 测试场景(输入) | 输入 Token | 输出 Token | Prefix Cache 命中率 |
|---|---|---|---|
| AI 编程/Agent(64K) | 65,536 | 1,024 | 90% |
| AI 编程/Agent(84K) | 84,000 | 1,024 | 90% |
AI 编程 / Agent(64K 输入)
| 并发数 | 首字延时 TTFT(s) | 整机输出 TPS | 单路输出 TPS |
|---|---|---|---|
| 1 | 1.85 | 91.67 | 91.67 |
| 2 | 2.47 | 133.60 | 66.80 |
| 4 | 3.19 | 160.98 | 40.24 |
| 6 | 3.93 | 188.86 | 31.48 |
| 8 | 4.29 | 173.08 | 21.64 |
| 10 | 13.33 | 182.50 | 18.25 |
说明:首字延时(即 TTFT)单位为秒(s),表格中为平均 TTFT;整机输出吞吐与单路输出吞吐单位为 tokens/s。
在 Prefix Cache 90% 前缀缓存命中率条件下,64K 输入场景单并发平均首字延时仅为 1.85 秒,6 并发时仍控制在 3.93 秒,体现出前缀缓存对超长上下文重复计算的优化效果。
整机输出吞吐随并发提升逐步增长,在 6 并发时达到 188.86 tokens/s,为本组测试最高值;此时单路输出吞吐为 31.48 tokens/s。当并发增加至 10 时,整机吞吐未能进一步突破此前峰值,而首字延时增长至 13.33 秒,说明系统已逐渐进入资源竞争更为明显的运行区间。
AI 编程 / Agent(84K 输入)
| 并发数 | 首字延时 TTFT(s) | 整机输出 TPS | 单路输出 TPS |
|---|---|---|---|
| 1 | 2.28 | 155.41 | 155.41 |
| 2 | 2.74 | 184.05 | 92.02 |
| 4 | 3.65 | 192.45 | 48.11 |
| 6 | 4.72 | 211.78 | 35.30 |
| 8 | 5.22 | 226.68 | 28.34 |
| 10 | 20.78 | 218.38 | 21.84 |
说明:首字延时(即 TTFT)单位为秒(s),表格中为平均 TTFT;整机输出吞吐与单路输出吞吐单位为 tokens/s。
在 84K 输入场景下,单并发平均首字延时为 2.28 秒,单路输出吞吐达到 155.41 tokens/s,表现出较好的低并发生成能力。随着并发的增加,整机输出吞吐持续提升,在 8 并发时达到 226.68 tokens/s,为本次 AI 编程 / Agent 测试中的最高值,此时平均首字延时为 5.22 秒,单路输出吞吐为 28.34 tokens/s。当并发进一步提升至 10 时,整机输出吞吐回落至 218.38 tokens/s,首字延时明显增加至 20.78 秒,表明继续提高并发已难以获得有效的吞吐收益。
综合两组测试来看,在较高前缀缓存命中率条件下,1Panel AI 一体机(4 × GB10 集群版)能够有效减少重复上下文计算,并为超长上下文任务提供持续生成能力。6 至 8 并发是本次 AI 编程 / Agent 测试中值得重点评估的运行区间。
四、生产环境运行实测
标准化压测能够反映模型在特定负载下的性能边界,而在实际业务环境中,请求长度、并发规模和前缀缓存命中率通常会不断变化。为进一步观察 1Panel AI 一体机(4 × GB10 集群版)的实际运行表现,我们将该模型接入飞致云生产环境的 AI 网关,为员工提供 WorkBuddy 智能体应用场景,并通过 1Panel 企业版的推理引擎监控功能,对模型的实时吞吐、前缀缓存命中率、首字延时及并发状态进行持续采集。以下数据来自模型上线后的实际运行监控记录。
1. 实时运行状态监控
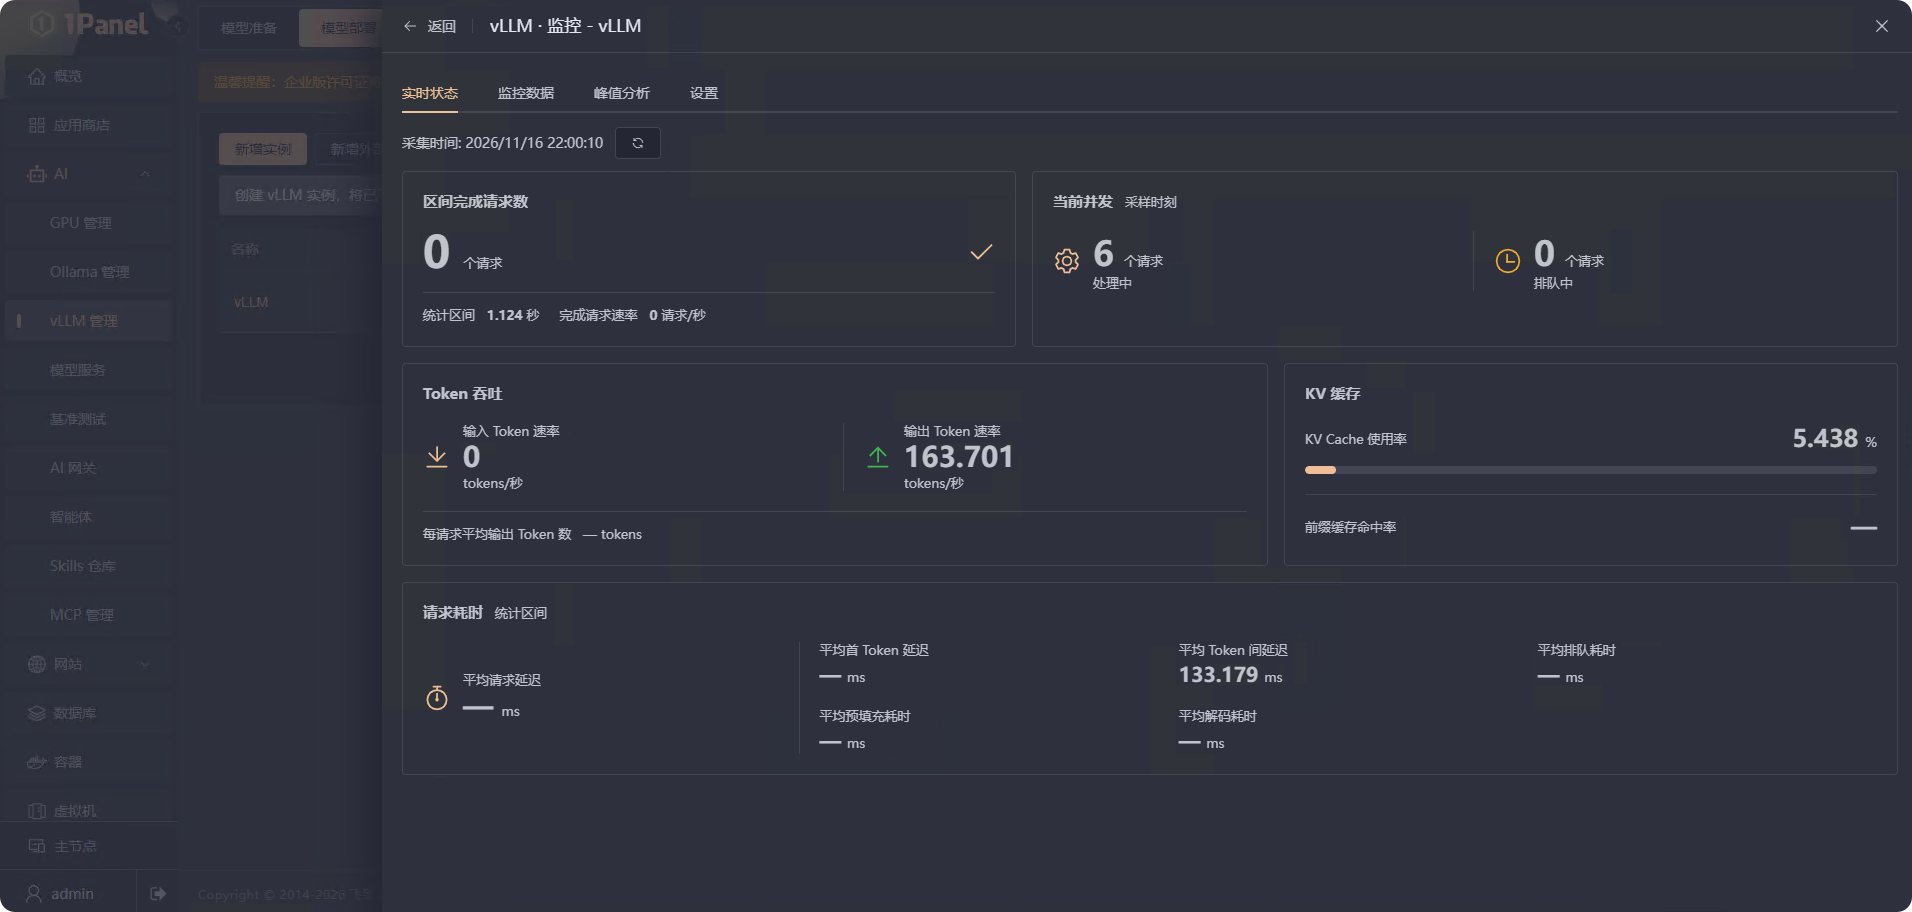
在实时监控截图中,可以观察到模型服务正在同时处理 6 路并发请求,实时输出 Token 速率达到 163.70 tokens/s。
2. Token 吞吐与缓存命中率
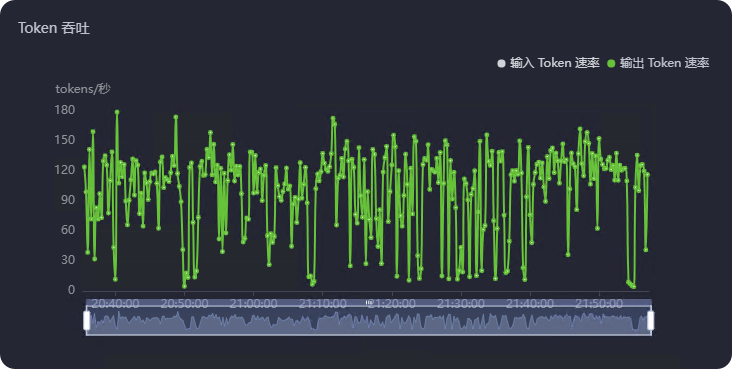
从实际运行的 Token 吞吐趋势来看,模型的输出速度并非始终保持在固定水平,而是随着请求负载变化出现波动。观察期间,输出 Token 速率多数采样点处于 120~150 tokens/s 的范围内,部分采样点接近 180 tokens/s。这种变化与实际业务中请求输入长度、输出长度和并发数量动态变化的特点相符。
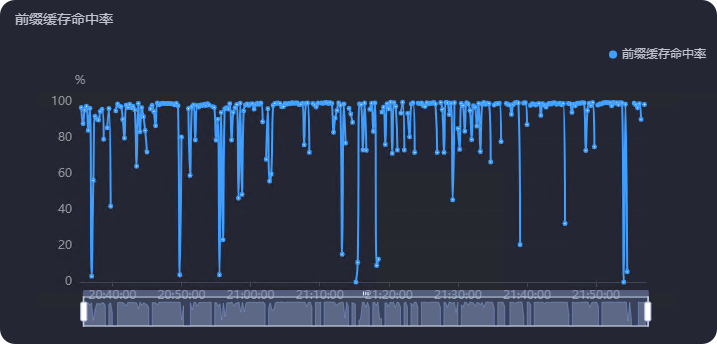
前缀缓存命中率监控显示,大部分采样点保持在 90% 以上,部分时间接近 100%,但也存在短暂下降的情况。这表明实际运行负载中存在较高比例的公共上下文复用,为减少重复 Prefill(预填充)计算提供了条件。特别是在 AI 编程和 Agent 场景中,系统提示词、工具定义和历史对话经常被重复使用,前缀缓存能够在一定程度上降低超长上下文请求的处理开销。不过,缓存命中率与请求内容密切相关,不同业务负载下的实际效果可能存在明显差异。
3. 首字延时
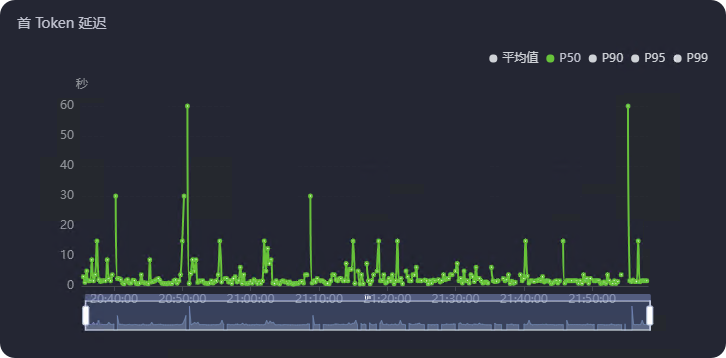
从实际运行监控可以看到,大部分时间模型的首字延时保持在 5 秒以内,即相对较低的水平,但部分采样点出现了十几秒甚至更高的延时峰值。产生这类波动的原因主要是超长上下文 Prefill、缓存未命中、请求排队或并发调度等。
4. 峰值分析
模型上线后,可以通过 1Panel 企业版的峰值分析能力,快速定位模型调用并发峰值区间,并分析各项关键指标。
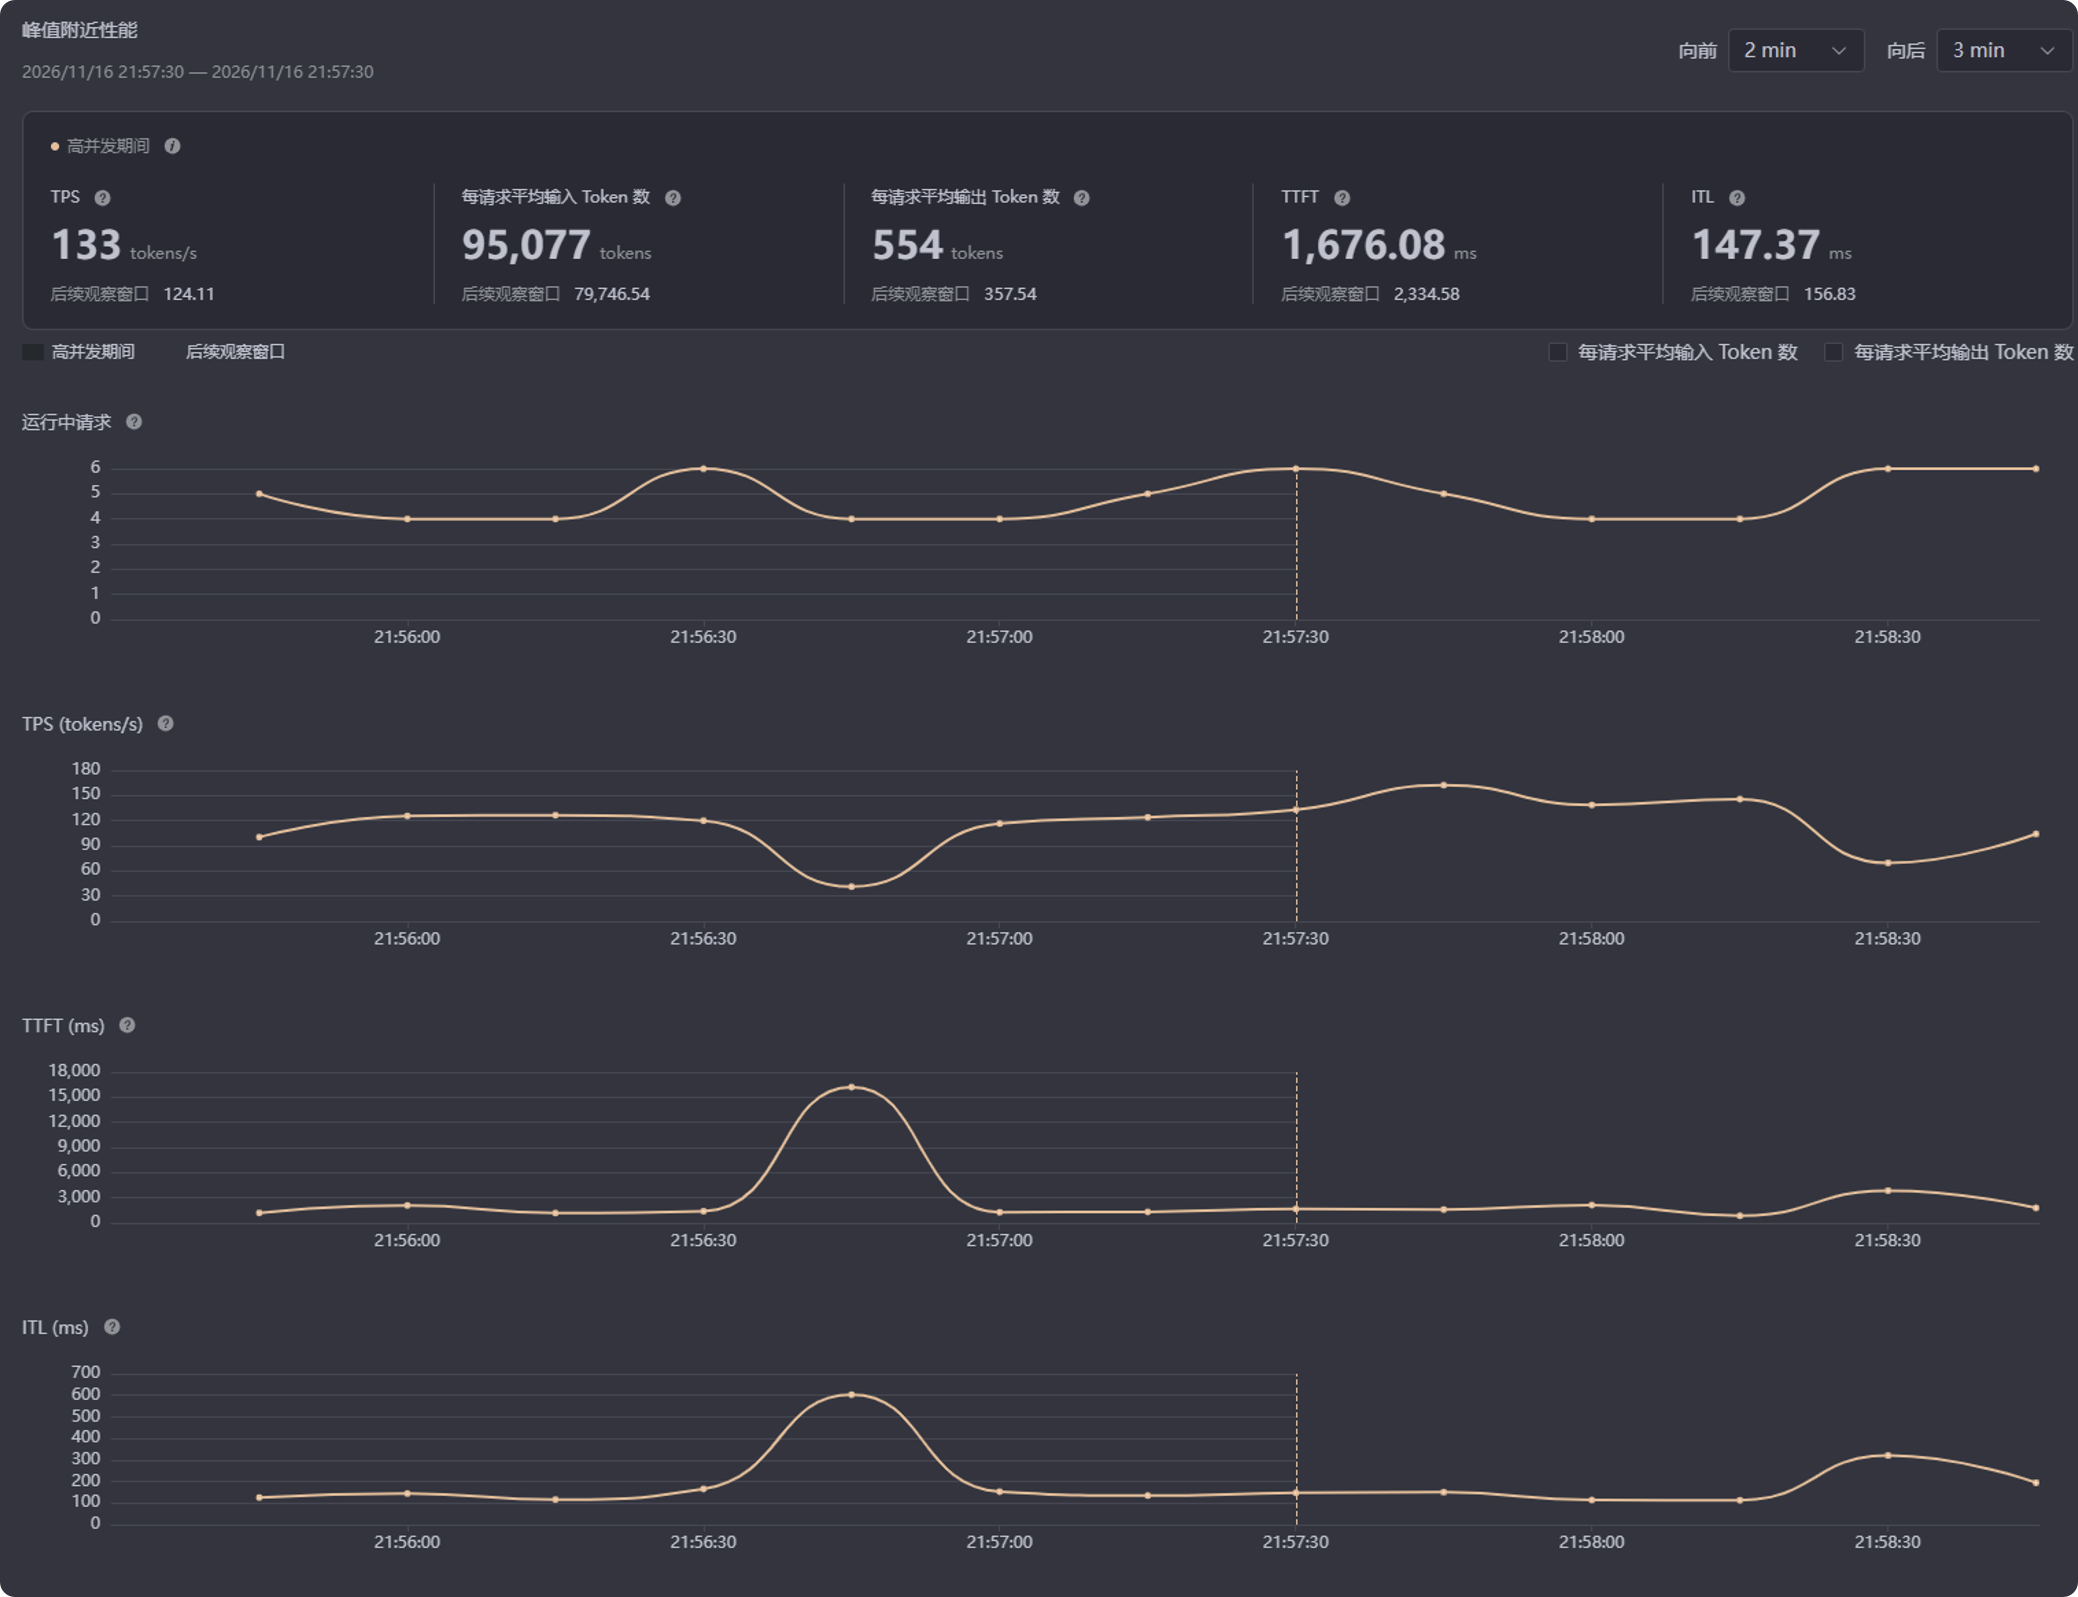
1Panel 企业版提供了 vLLM 峰值分析能力,可以针对特定时间窗口,将运行并发、Token 吞吐、输入输出长度及请求延时等指标进行关联观察。在某采样窗口中,其监控记录如下:
| 监控指标 | 采样结果 |
|---|---|
| 整机输出吞吐 TPS | 133 tokens/s |
| 请求平均输入 Token 数 | 95,077 |
| 请求平均输出 Token 数 | 554 |
| 平均首字延时(TTFT) | 1,676.08ms |
| 最高运行并发 | 6 |
从这一时间窗口来看,模型处理的请求具有明显的长输入特征,平均输入长度超过 95K Tokens。在最高运行并发为 6 的条件下,整机输出吞吐为 133 tokens/s,平均首字延时约为 1.68 秒。在当前实际运行负载下,四节点 GB10 集群能够同时处理多个超长输入请求,并维持一定的持续输出能力。
五、总结
在 1Panel AI 一体机(4 × GB10 集群版)私有化部署 DeepSeek-V4.1-Flash-1017 并进行多场景性能测试后,从实际测试结果看:
- 模型承载方面:512GB LPDDR5X 统一内存为大模型的分布式加载与运行提供了容量基础;
- 通用业务场景方面:短对话单并发平均首字延时仅 0.54 秒,复杂任务最高整机输出吞吐达到 180.43 tokens/s;
- AI 编程 / Agent 方面:在 90% 前缀缓存命中率条件下,84K 输入场景的最高整机输出吞吐可达 226.68 tokens/s;
- 实际运行方面:通过 1Panel 企业版的可视化监控能力,能够持续观察模型的并发、吞吐、缓存及延时变化,为本地化模型的运行优化和容量规划提供数据支持。
相比传统的多卡 GPU 服务器,4 节点 GB10 集群方案的特点并不在于追求极致的推理吞吐,而是通过紧凑型的算力节点、大容量统一内存与高速交换网络,为企业提供一种灵活、可扩展的大模型私有化部署方案。
