
1Panel AI 一体机(方案六)实测报告:8 卡部署 DeepSeek-V4.1-Flash-1017
在 1Panel AI 一体机(方案六,8 × NVIDIA RTX Pro 5000 Blackwell 72GB / 512GB 内存 / 4TB SSD)上,使用 vLLM 以 TP8+EP8 并行策略部署 DeepSeek-V4.1-Flash-1017,完成通用业务与 AI 编程 / Agent 两类负载的多并发压测。本文完整给出 1–64 并发下的首字延时(TTFT)、整机输出吞吐与单路输出吞吐实测数据,以及 90% Prefix Cache 命中率下 64K / 84K 超长上下文场景的表现与并发容量建议。
当企业开始将大模型应用于 AI 编程、Agent(智能体)等复杂任务时,模型的价值不再局限于回答问题或生成内容,而是进一步延伸至代码理解、项目开发、工具调用和多步骤任务执行。与此同时,这类高阶应用也对底层推理基础设施提出了更高要求:单次请求的上下文规模可能达到数万甚至十万 Tokens,多轮任务执行过程中还会反复使用大量相同的历史信息。对于企业而言,选择一个具备优秀编程和 Agent 能力的模型只是第一步,如何在企业本地部署大模型,并保障长上下文、多轮交互和多用户并发下的推理体验,同样重要。
2026 年 10 月,DeepSeek 发布了 DeepSeek-V4.1-Flash-1017 模型,进一步强化了编程和 Agent 能力。近期,飞致云基于 1Panel AI 一体机(方案六),采用 8 张 NVIDIA RTX Pro 5000 Blackwell 72GB 加速卡,完成了该模型的企业私有化部署,并针对 AI 编程、Agent、复杂任务和常规对话等工作负载开展性能测试。本文将围绕 AI 编程与 Agent 场景,结合模型能力基准、实际部署配置和多并发压测数据,分析该方案在企业本地环境中的推理表现与应用价值。
一、DeepSeek-V4.1-Flash-1017 简介
DeepSeek-V4.1-Flash-1017 延续了 DeepSeek-V4.1-Flash 的高效稀疏 MoE 架构,在保持较低单 Token 计算开销的同时,进一步强化了代码生成、工具调用、复杂推理和长链路任务执行能力。从企业应用的角度来看,这一模型的价值不仅在于能够回答更加复杂的问题,更在于它能够作为智能体的核心推理引擎,参与多个步骤连续执行的实际业务流程。其主要技术特点如下:
- 大规模稀疏 MoE 架构:总参数规模约 552B,通过稀疏专家激活机制控制单 Token 计算量,在模型能力与推理效率之间取得平衡;
- 百万 Token 上下文:支持约 1M Token 上下文窗口,为大型代码仓库分析、超长文档理解和复杂智能体任务提供基础;
- 编程与智能体能力增强:进一步改善代码生成、工具调用和多步骤任务执行表现,适用于企业内部研发与业务自动化场景;
- 长上下文处理能力:能够在单次请求中接收更大规模的上下文信息,减少复杂任务中反复截断、拆分和拼接内容的需求;
- 推理效率优化:通过模型架构、缓存和推理策略优化,为企业构建高性能的本地 AI 服务提供条件。
二、1Panel AI 一体机 8 卡私有化部署方案
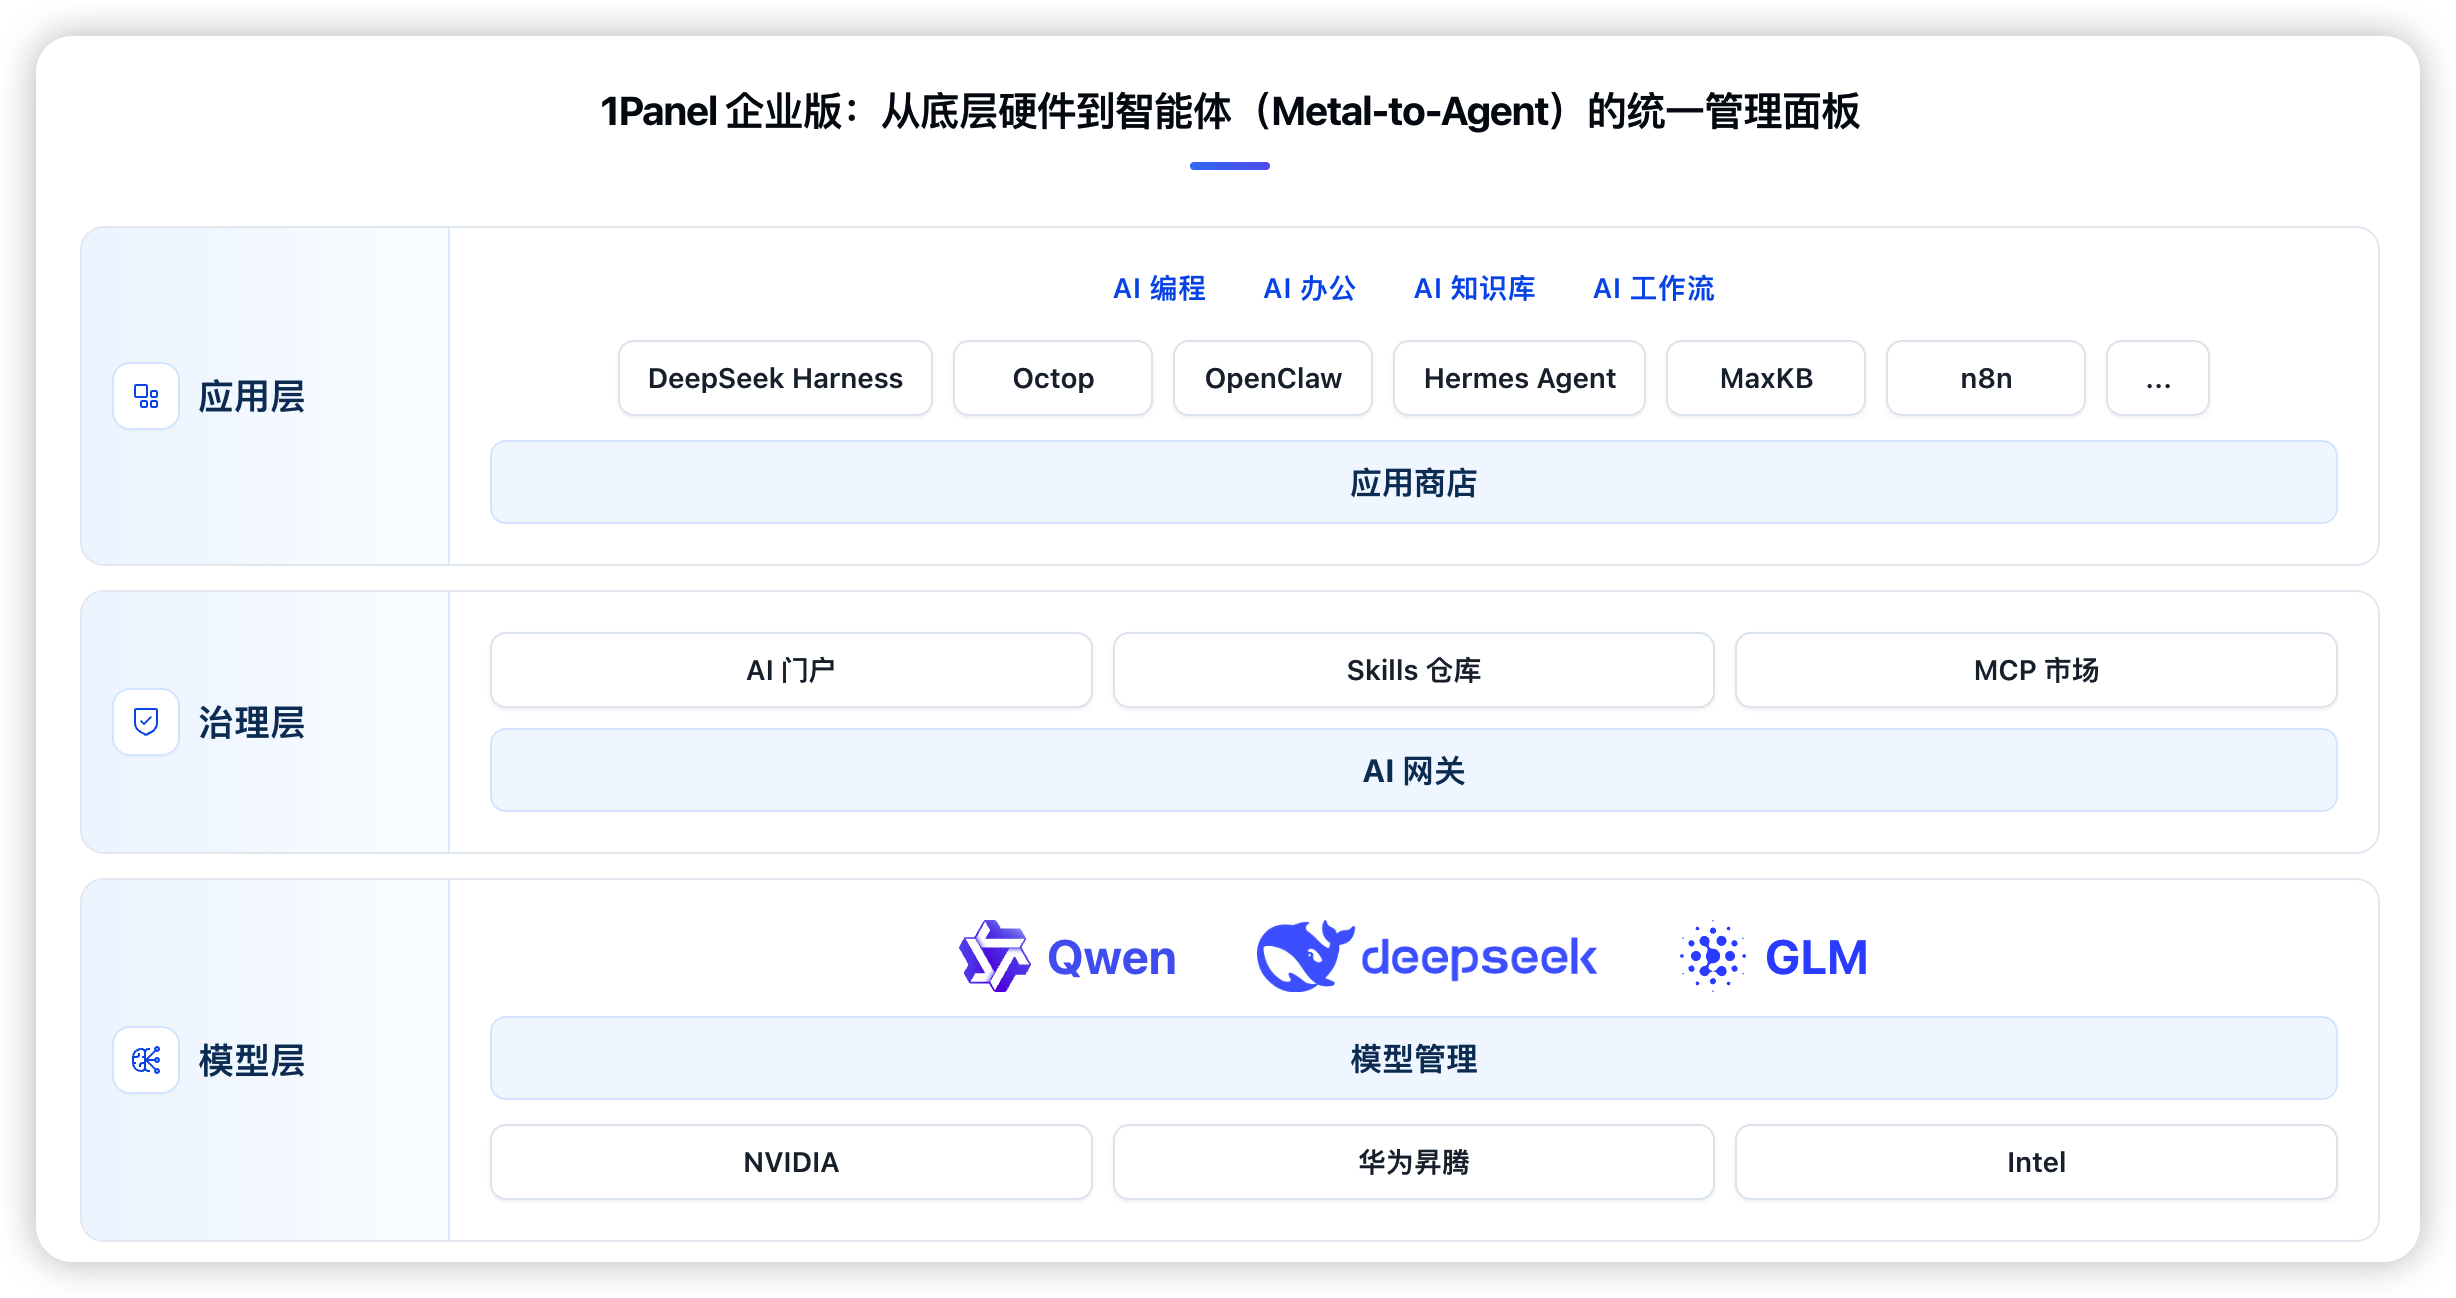
2026 年 7 月,飞致云发布了 1Panel AI 一体机产品家族。这一产品系列采用类「超融合」的产品理念,将底层计算资源、模型服务和 AI 应用进行整合,为企业提供开箱即用的私有化 AI 基础设施。与需要自行采购服务器、配置 GPU 环境、适配推理框架和建设应用平台的传统方式相比,一体机交付的是经过验证的软硬件组合,能够降低企业构建本地 AI 服务的工程复杂度。本次测试在 1Panel AI 一体机(方案六,8 卡服务器版) 上部署 DeepSeek-V4.1-Flash-1017,通过真实环境测试新款模型在企业级应用场景中的实际性能表现。
硬件与推理参数
- 机头:4U 机架式服务器
- CPU:2 颗 Intel Xeon Gold 6530
- 内存:512GB
- 存储:4TB SSD
- 加速卡:8 张 NVIDIA RTX Pro 5000 Blackwell 72GB
- 模型:DeepSeek-V4.1-Flash-1017
- 推理引擎:vLLM
- 模型精度:官方原生 FP4+FP8 混合精度
- KV Cache 精度:FP8
- 并行策略:TP8+EP8
- 上下文窗口:1M
- 投机解码:DSpark K5
- Engram:主机内存
内置软件
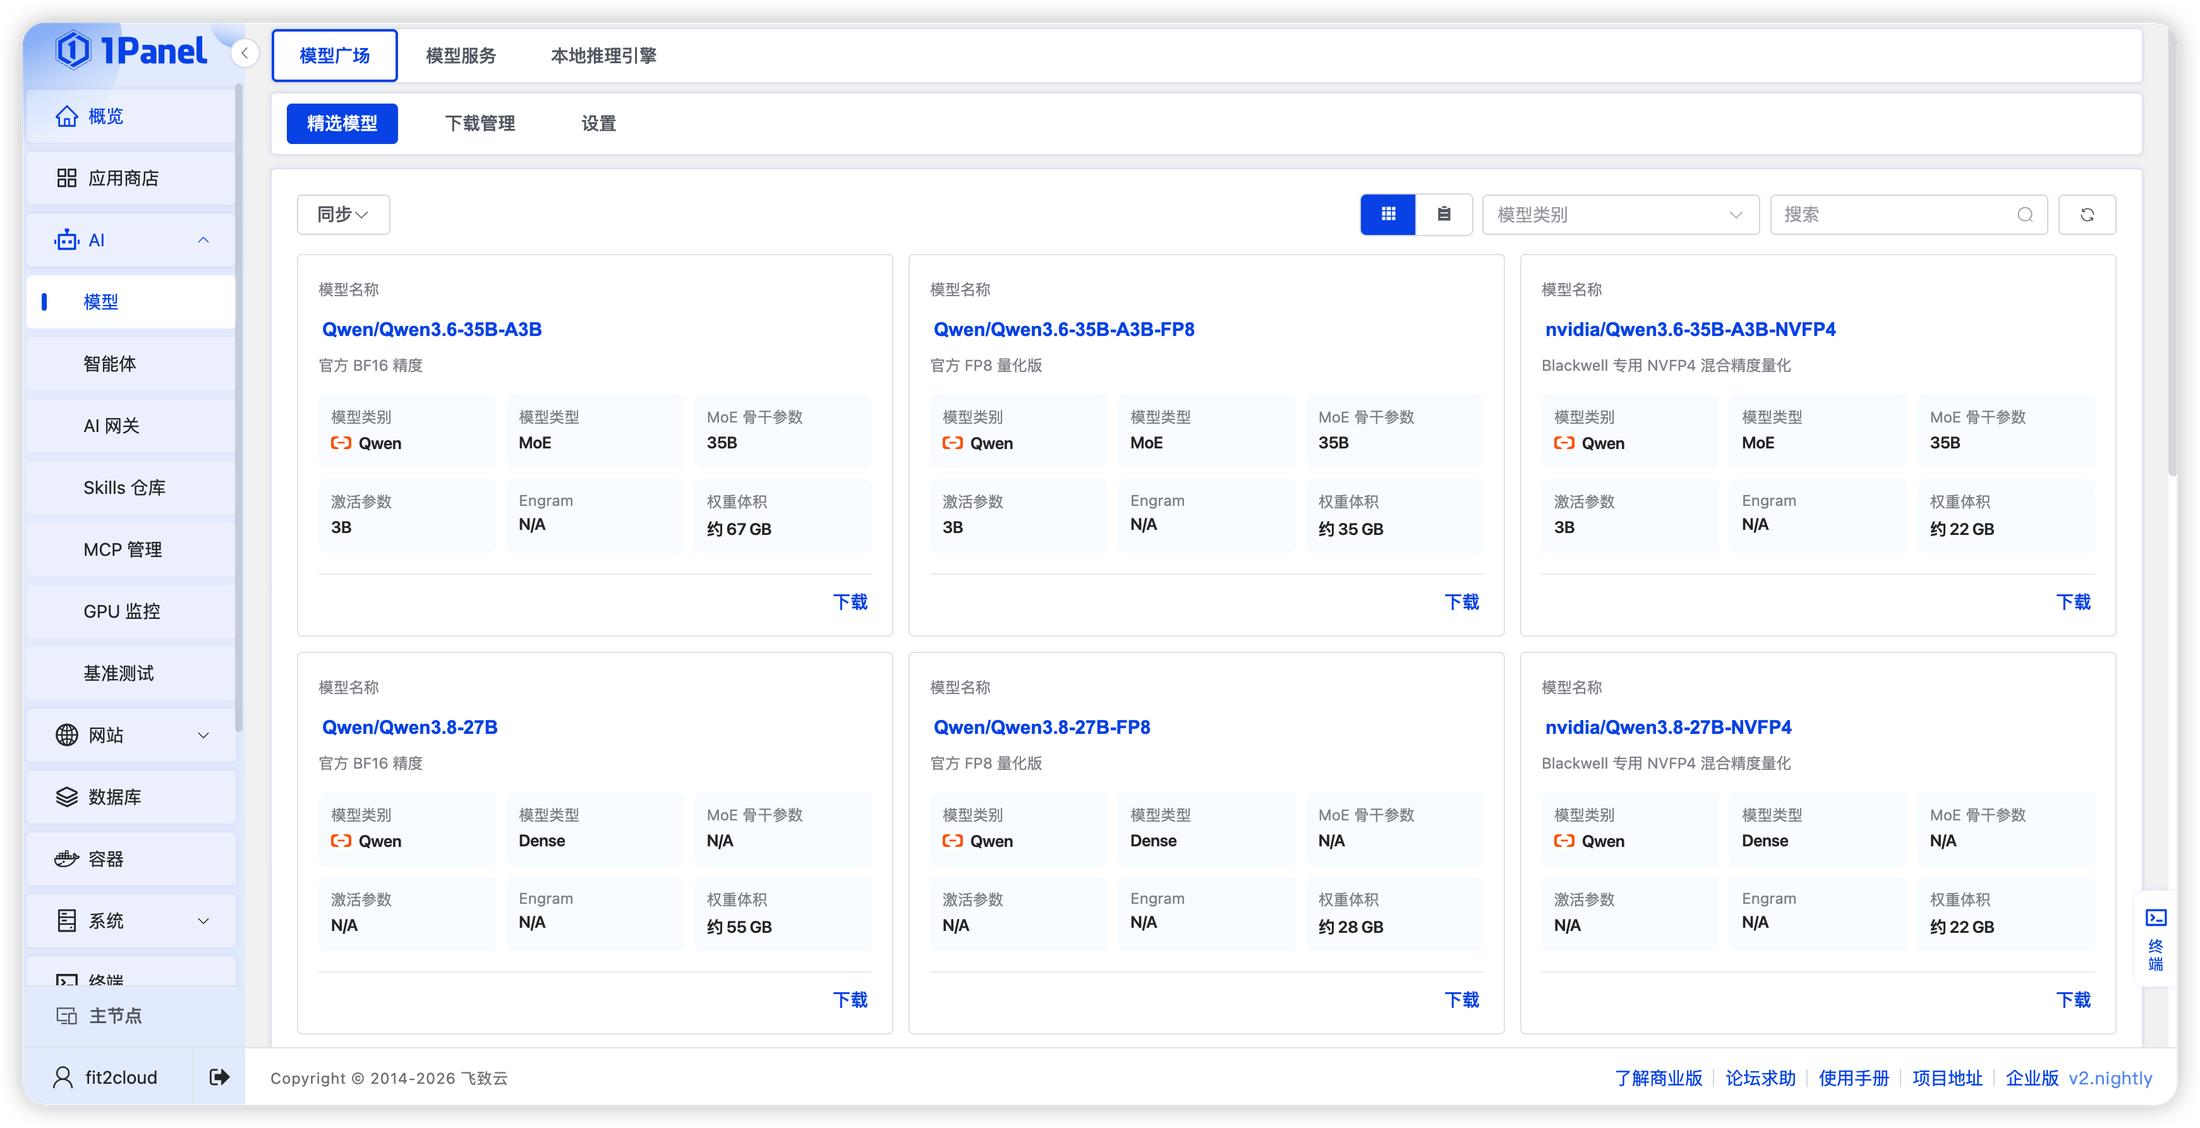
- 1Panel 企业版:面向 AI 服务器的管理面板,打通从 GPU 管理、模型准备、模型部署、模型服务、基准测试到对外提供 Token 服务的全流程闭环;
- MaxKB 企业版:开源企业级智能体平台,用于降低企业 AI 落地面临的技术门槛、部署成本与迭代周期。
三、DeepSeek-V4.1-Flash-1017 性能实测
对于企业私有化部署而言,大模型的实际应用价值不仅取决于模型能力,还取决于其在不同业务负载下的推理性能。尤其是在多用户并发、长上下文处理等场景中,模型的响应速度和吞吐能力将直接影响业务系统的使用体验。本次测试基于 1Panel AI 一体机(方案六),围绕企业常见的 AI 应用负载,将测试场景划分为以下两类:
- 通用业务场景:包括短对话、长文档总结 / RAG(检索增强生成),以及通用复杂任务,覆盖日常办公助手、企业知识库、文档分析等应用;
- AI 编程 / Agent 场景:重点模拟大型代码仓库分析、多轮工具调用和复杂智能体任务,考察模型在超长上下文及高前缀缓存命中率条件下的推理表现。
两类场景均从首字延时(TTFT)、整机输出吞吐和单路输出吞吐三个维度进行分析,分别反映模型的首次响应速度、服务器整体推理产能,以及单个用户能够获得的实际文本生成速度。
1. 通用业务场景
通用业务场景覆盖企业 AI 助手、知识库问答、文档总结及复杂问题分析等任务,分别设置三组测试负载:
| 测试场景 | 输入 Token | 输出 Token |
|---|---|---|
| 短对话 | 1,024 | 256 |
| 长文档总结/RAG | 8,192 | 1,024 |
| 通用复杂任务 | 16,384 | 2,048 |
首字延时(TTFT)
| 并发数 | 短对话 | 长文档总结/RAG | 复杂任务 |
|---|---|---|---|
| 1 | 0.17s | 1.16s | 2.26s |
| 4 | 0.32s | 1.74s | 3.31s |
| 8 | 0.48s | 2.43s | 4.62s |
| 12 | 0.60s | 3.13s | 5.97s |
| 16 | 2.54s | 11.82s | 21.86s |
| 24 | 6.64s | 29.05s | 54.33s |
| 32 | 10.68s | 46.51s | 87.21s |
| 48 | 18.10s | 83.83s | - |
| 64 | 27.03s | - | - |
说明:首字延迟(即 TTFT)单位为秒(s),表格中测试数据为平均 TTFT。
在短对话场景下,单并发平均首字延时仅 173ms,12 并发时仍控制在 0.60 秒左右,具备较好的交互响应能力。随着输入长度及并发增加,首字延时逐步上升。尤其从 12 并发提升至 16 并发时,三类场景均出现明显的延时增长,表明系统逐渐进入资源竞争和请求排队更为明显的运行区间。
整机输出吞吐(TPS)
| 并发数 | 短对话 | 长文档总结/RAG | 复杂任务 |
|---|---|---|---|
| 1 | 117.19 | 140.42 | 174.68 |
| 4 | 277.05 | 299.53 | 311.38 |
| 8 | 377.13 | 352.37 | 416.24 |
| 12 | 431.71 | 399.92 | 395.48 |
| 16 | 434.29 | 386.65 | 428.89 |
| 24 | 428.52 | 403.48 | 416.91 |
| 32 | 430.01 | 395.8 | 436.03 |
| 48 | 450.06 | 394.93 | - |
| 64 | 432.48 | - | - |
说明:整机输出吞吐(TPS)单位为 tokens/s。
在低并发阶段,增加并发能够显著提升整机输出能力。以短对话场景为例,整机输出吞吐从单并发的 117.19 tokens/s 提升至 12 并发的 431.71 tokens/s,约为单并发的 3.68 倍。当并发进一步提高至 24、48 乃至 96 时,短对话场景的整机吞吐基本维持在 430–450 tokens/s 附近,未随并发数量持续增长。RAG 和复杂任务场景也呈现类似趋势,整体输出吞吐在较高并发下逐步进入平台期。表明系统的生成产能已接近当前配置下的有效上限,继续增加并发带来的收益有限。
单路输出吞吐(TPS)
| 并发数 | 短对话 | 长文档总结/RAG | 复杂任务 |
|---|---|---|---|
| 1 | 117.19 | 140.42 | 174.68 |
| 4 | 69.26 | 74.88 | 77.85 |
| 8 | 47.14 | 44.05 | 52.03 |
| 12 | 35.98 | 33.33 | 32.96 |
| 16 | 27.14 | 24.17 | 26.81 |
| 24 | 17.85 | 16.81 | 17.37 |
| 32 | 13.44 | 12.37 | 13.63 |
| 48 | 9.38 | 8.23 | - |
| 64 | 6.76 | - | - |
说明:单路输出吞吐(TPS)单位为 tokens/s。
单并发条件下,三类场景的单路输出吞吐达到 117–175 tokens/s,能够提供较快的文本生成体验。随着并发的增加,单路生成速度逐步下降。在 8–12 并发区间,三类场景的单路输出吞吐约为 33–52 tokens/s;当短对话并发提高至 96 时,单路输出吞吐下降至 4.52 tokens/s。这一结果表明,虽然高并发能够提高 GPU 的资源利用率,但在整机吞吐进入平台期后,继续增加并发会显著降低单个用户的 Token 生成速度。
2. AI 编程 / Agent 场景
AI 编程和 Agent 场景通常涉及代码仓库分析、多轮工具调用及复杂任务执行,具有上下文长、重复内容多、多轮交互频繁等特点。本次测试分别设置 64K 和 84K 输入、1K 输出,并且采用 90% Prefix Cache 命中率,模拟智能体任务中的上下文复用场景。
首字延时(TTFT)
| 并发数 | 64K 输入 | 84K 输入 |
|---|---|---|
| 1 | 1.08s | 1.35s |
| 4 | 1.77s | 2.12s |
| 8 | 2.46s | 2.83s |
| 12 | 2.72s | 3.87s |
| 16 | 10.38s | 11.28s |
| 20 | 17.98s | 19.33s |
在 90% 前缀缓存命中率条件下,即使输入达到 64K–84K Tokens,单并发平均首字延时仍控制在 1.08–1.35 秒,12 并发时首字延时分别为 2.72 秒和 3.87 秒。Prefix Cache 能够有效减少重复上下文计算,改善长上下文任务的响应效率。但当并发超过 12 后,首字延时明显增加。
整机输出吞吐(TPS)
| 并发数 | 64K 输入 | 84K 输入 |
|---|---|---|
| 1 | 178.63 | 169.87 |
| 4 | 341.55 | 327.62 |
| 8 | 400.57 | 376.53 |
| 10 | 453.79 | 380.21 |
| 12 | 437.88 | 395.32 |
| 16 | 445.3 | 428.74 |
| 20 | 453.62 | 438.33 |
说明:整机输出吞吐(TPS)单位为 tokens/s。
在 64K 场景下,10 并发整机输出吞吐达到 453.79 tokens/s;84K 场景下,20 并发时整机输出吞吐达到 438.33 tokens/s。由此可见,在较高缓存命中率条件下,超长上下文负载仍能够获得较好的整机输出能力。不过,随着吞吐逐步进入平台期,继续提高并发会明显增加首字等待时间。
单路输出吞吐(TPS)
| 并发数 | 64K 输入 | 84K 输入 |
|---|---|---|
| 1 | 178.63 | 169.87 |
| 4 | 85.39 | 81.9 |
| 8 | 50.07 | 47.07 |
| 12 | 36.49 | 32.94 |
| 16 | 27.83 | 26.8 |
| 20 | 22.68 | 21.92 |
说明:单路输出吞吐(TPS)单位为 tokens/s。
单路输出吞吐兼顾复杂任务的持续生成效率。在单并发条件下,64K 输入和 84K 输入场景的输出速度分别达到 178.63 tokens/s 和 169.87 tokens/s;8 并发时仍保持约 47–50 tokens/s,能够为代码生成和智能体任务提供较快的持续输出能力。随着并发的增加,单路输出速度逐渐降低。结合首字延时与整机吞吐表现,8–12 并发可作为此类高缓存命中负载的重点容量评估区间。
四、测试总结
本次实机测试表明,配备了 8 张 NVIDIA RTX PRO 5000 Blackwell 72GB 加速卡的 1Panel AI 一体机方案,能够为 DeepSeek-V4.1-Flash-1017 模型提供较好的本地推理能力。
- 在通用业务场景下,短对话单并发平均首字延时仅为 0.17s,多并发整机输出吞吐可达到约 400–450 tokens/s;
- 在 AI 编程 / Agent 场景下,通过前缀缓存复用,64K–84K 超长上下文同样能够保持较好的响应和生成性能,多并发整机输出吞吐仍可超过 400 tokens/s,10 并发时单路输出吞吐可达到 40 token/s 左右,16 并发时单路输出吞吐仍可达较为流畅的 27 tokens/s,实际部署时建议采纳 10~16 并发。
本次测试也表明,更高的并发并不意味着更好的使用体验,不同业务建议采用不同的并发策略。当整机吞吐逐渐达到平台期后,首字延时和单路输出速度可能明显恶化。因此,企业在实际部署时,应该根据业务对响应速度、上下文长度和吞吐能力的不同要求,合理规划并发容量,充分发挥 8 卡方案的推理性能。
五、结语
DeepSeek-V4.1-Flash-1017 的发布,为企业私有化部署高能力大模型提供了新的选择。但对于企业用户而言,衡量一款模型是否适合生产应用,既要关注其在第三方评测中的能力表现,也要通过实际部署验证硬件资源消耗、并发吞吐、响应延时,以及不同业务场景下的运行表现。企业私有化 AI 的价值,并不只是让大模型在本地运行,而是通过合理的软硬件选型、推理优化和资源治理,使模型能力真正转化为可持续交付的业务服务。
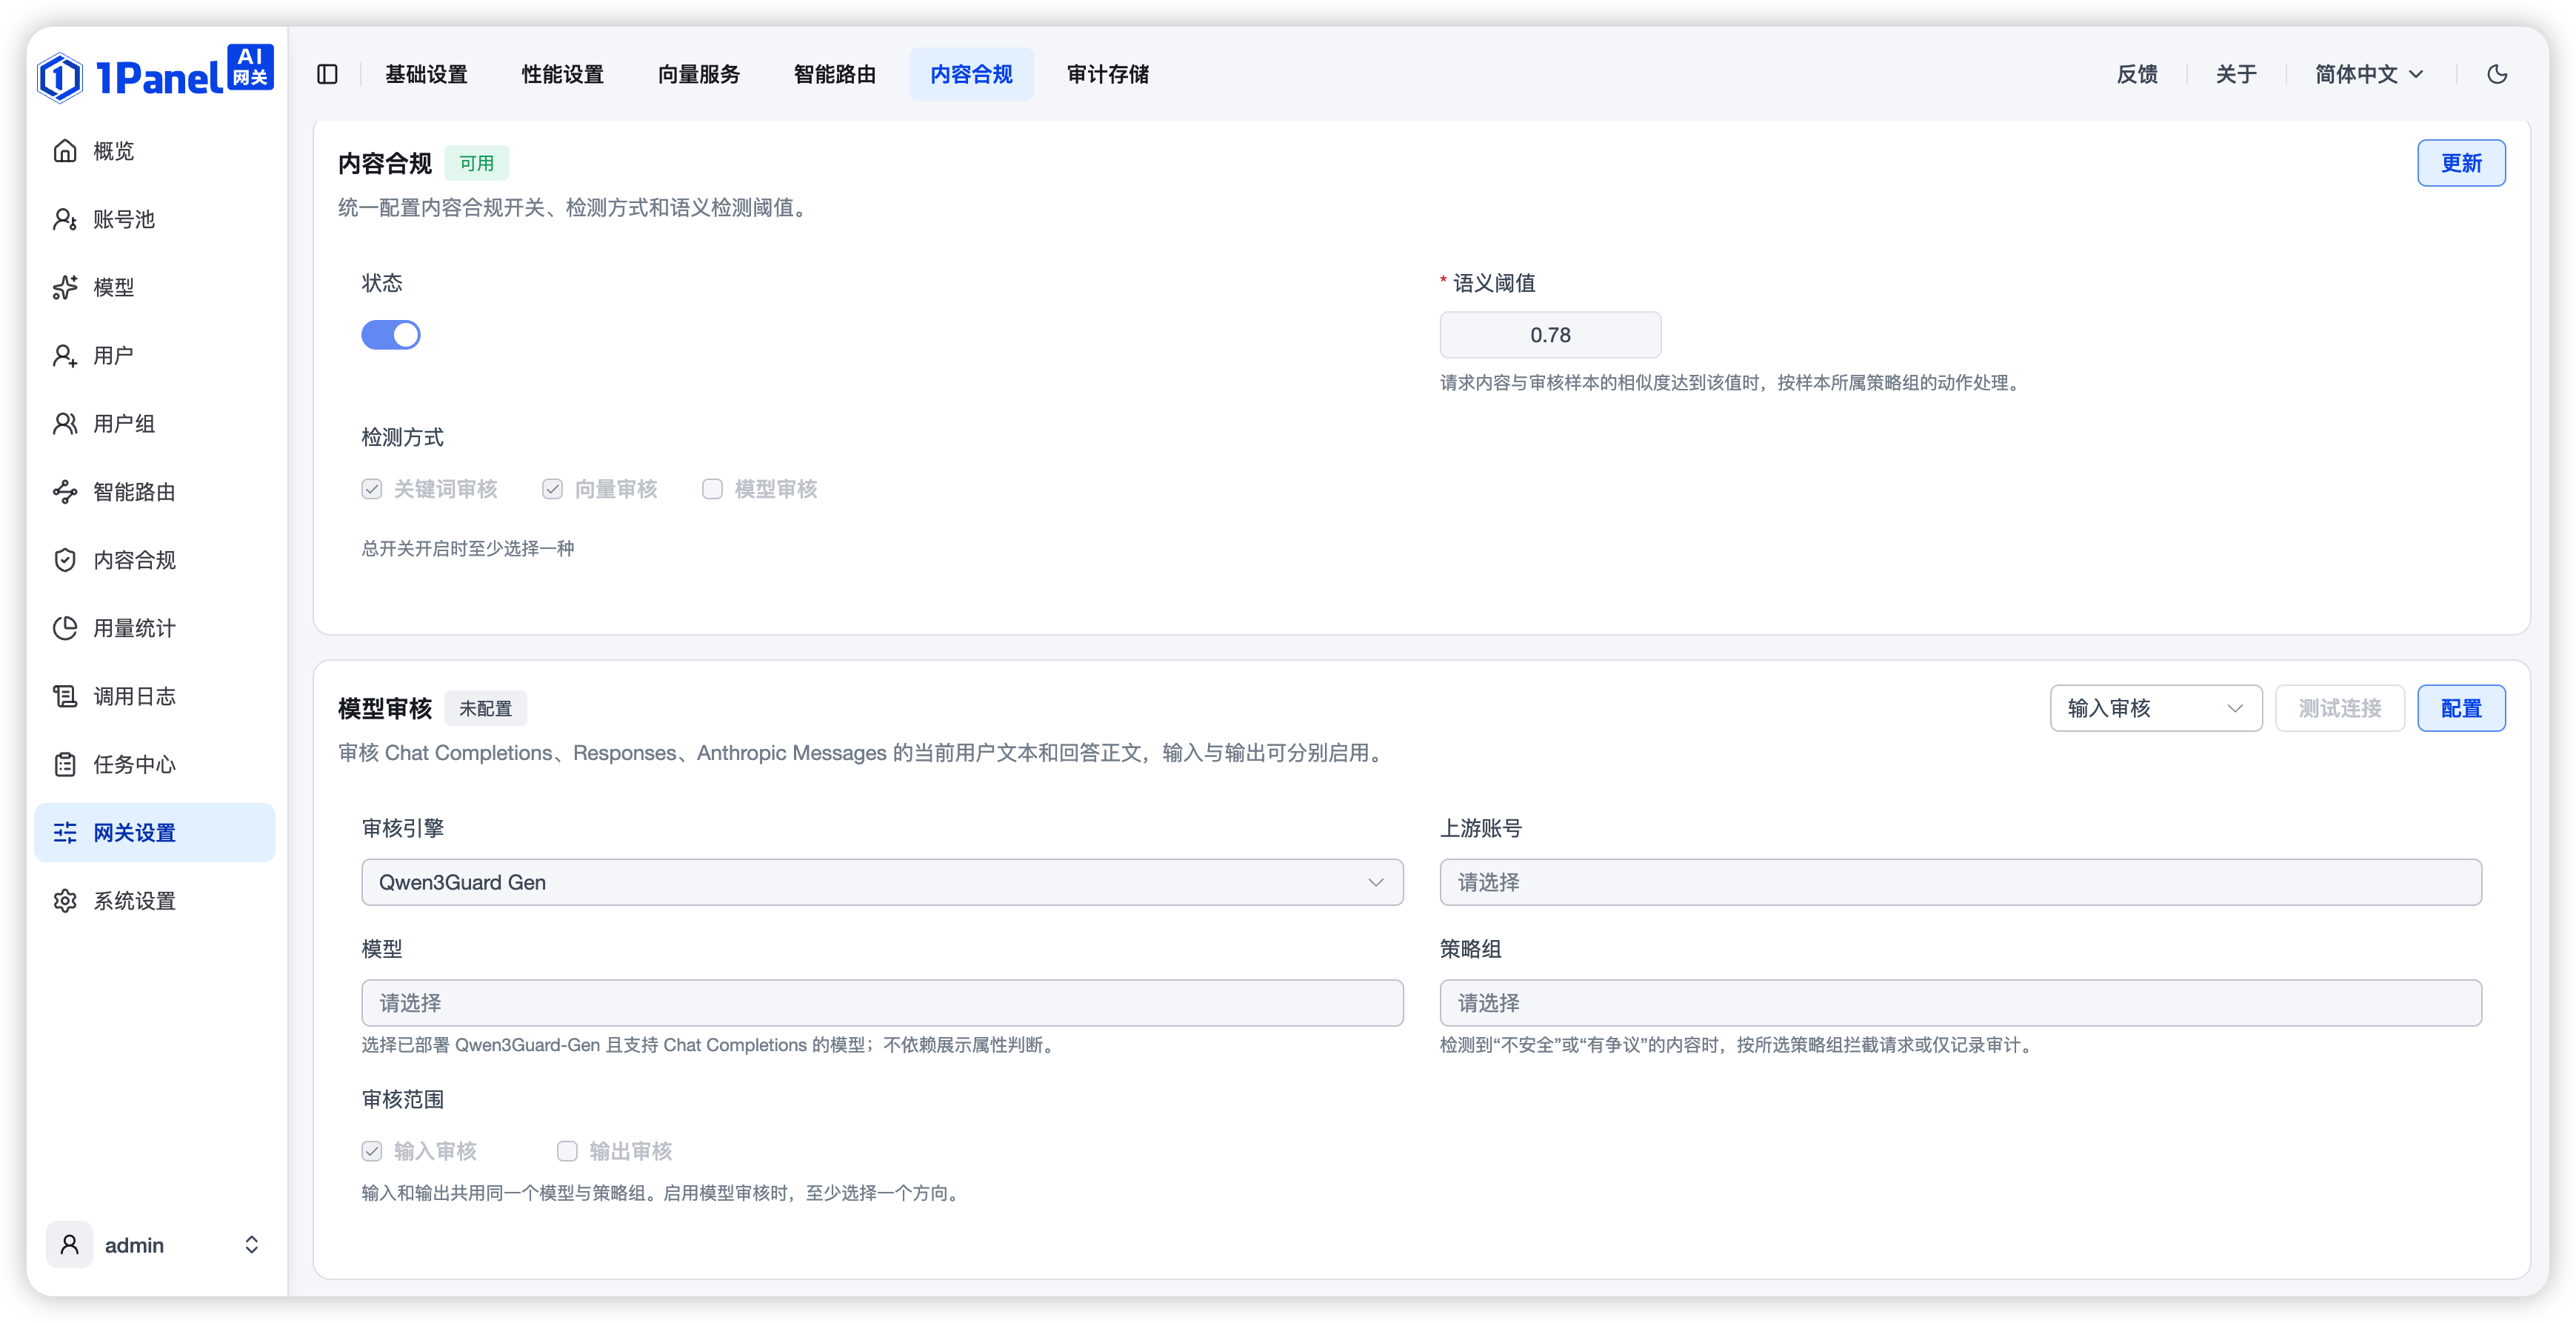
1Panel AI 一体机以「超融合」理念整合经过适配的算力、推理引擎、AI 服务器管理面板、AI 网关和 AI 应用,覆盖本地私有大模型部署与 Token 服务交付的管理链路。后续继续围绕主流开源大模型开展软硬件适配和性能验证,有助于为不同规模的业务负载提供有实测数据支撑的部署参考。
